
很多公司導入 AI 半年後,老闆都想問同一個問題:「大家現在 AI 用得怎麼樣?」
- 主管去問團隊,得到的答案是「有啊,很好用」
- HR 發了一份問卷,每個人都勾了「經常使用」
- 面試新人時,應徵者說自己「精通 Prompt」
三個答案講的再流利,還是很難分出是不是經常在用,還是只在面試前兩天惡補了幾支 YouTube 影片?
於是,我做了一個開源工具叫「AI 幾級了?」,起點是我跟有序設計的陳敬儒吃飯時聊出來的。
我們聊到:公司要怎麼知道團隊的 AI 能力到哪裡?問卷不準,口頭報告更不準!
敬儒先做了一套通用的檢核 Prompt,讓使用者手動貼上對話來健檢。
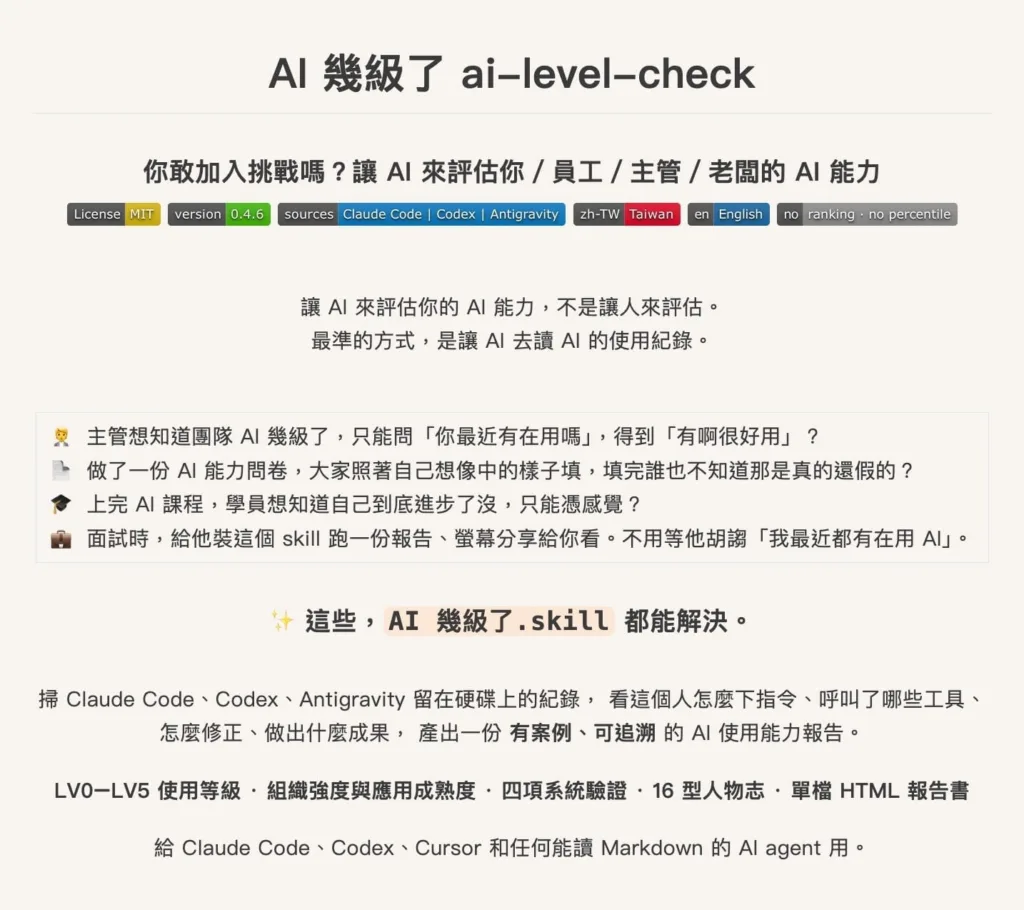
我則是優化成能自動掃描本機紀錄,讓 AI 去讀每個人電腦裡真實的 AI 對話紀錄,產出一份有證據、可追溯的 AI 使用能力報告。
為什麼 AI 能力這麼難評估?
在做這個工具之前,我試過各種方法評估團隊和學員的 AI 能力。每一種都卡在某個地方:
| 做法 | 實際會發生什麼 | 卡在哪 |
|---|---|---|
| 主管口頭問「最近有在用 AI 嗎?」 | 得到「有啊!很好用」 | 答案沒有細節,也無從查證 |
| 發 AI 能力問卷 | 大家照著想像中的自己填 | 自評偏差,填完誰也不知道真假 |
| 面試聽應徵者自述 | 「我精通 Prompt」 | 分不出真的用過,還是前兩天惡補 |
| 認證考試 | 拿到分數或證照 | 測得到知識,測不到使用行為 |
追根究柢,人評人有三件事躲不掉:看不到、記不住、有情緒。
主管看不到你半夜跟 AI 來回八次才修好一個 bug,只看得到週會上那三分鐘的口頭報告。
他記不住你三個月前的樣子,只記得上禮拜那次做得不錯。而且他今天心情好不好,也會影響他怎麼讀你交出來的東西。
AI 沒有這三個問題。它讀得完每一則對話、記得住整段期間,對你也沒有任何人際上的好惡。
重點:一個人的 AI 能力,藏在他每天跟 AI 的對話紀錄裡。能把這些紀錄讀完的,只有 AI。
AI 使用等級怎麼區分?怎麼使用?
「AI 幾級了」(ai-level-check)會掃描你電腦裡 Claude Code、Codex、Antigravity 等 AI Agent 留在硬碟上的真實對話紀錄,看你怎麼下指令、呼叫了哪些工具、怎麼修正、做出什麼成果,最後產出一份單檔 HTML 報告。
報告裡有三樣東西:
- LV0–LV5 使用等級:你目前的 AI 用法到哪個門檻?
- 16 型 AI 使用人物誌:你用 AI 的習慣屬於哪一型?
- 改善建議:指出具體案例與下一步行動。
AI 使用等級:LV0 到 LV5 怎麼分?
| 等級 | 名稱 | 紀錄裡看得到什麼 |
|---|---|---|
| LV0 | 問答靠人品 | 該補條件、該查核的任務,沒處理就直接採用答案 |
| LV1 | 換句話重問 | 察覺得到錯誤,靠換說法、多問幾次推進 |
| LV2 | 單點式應用 | 某一類任務已經能穩定交給 AI 完成,判斷得出答案能不能用 |
| LV3 | 精準下指令 | 給得出背景、範圍與完成標準;答錯時指得出具體問題 |
| LV4 | 模組化使用 | 把有效做法固定成模板、Skill 或代理,啟用前會實際測試 |
| LV5 | 系統級營運 | 分工、例外處理、維護與回寫整合成一套會自己跑的系統 |
等級的判定有三條硬規則:
- LV0 不會被當成預設值:掃不到紀錄,報告會寫「無法定級」。
- LV4、LV5 一定要有實作證據:只有構想、自述,或 AI 宣稱「已完成」,都不算。
- 未觀察到不等於不會:這段期間沒讀到某個等級的用法,報告只會說「沒讀到」,不會判你做不到。
16 型 AI 使用人物誌
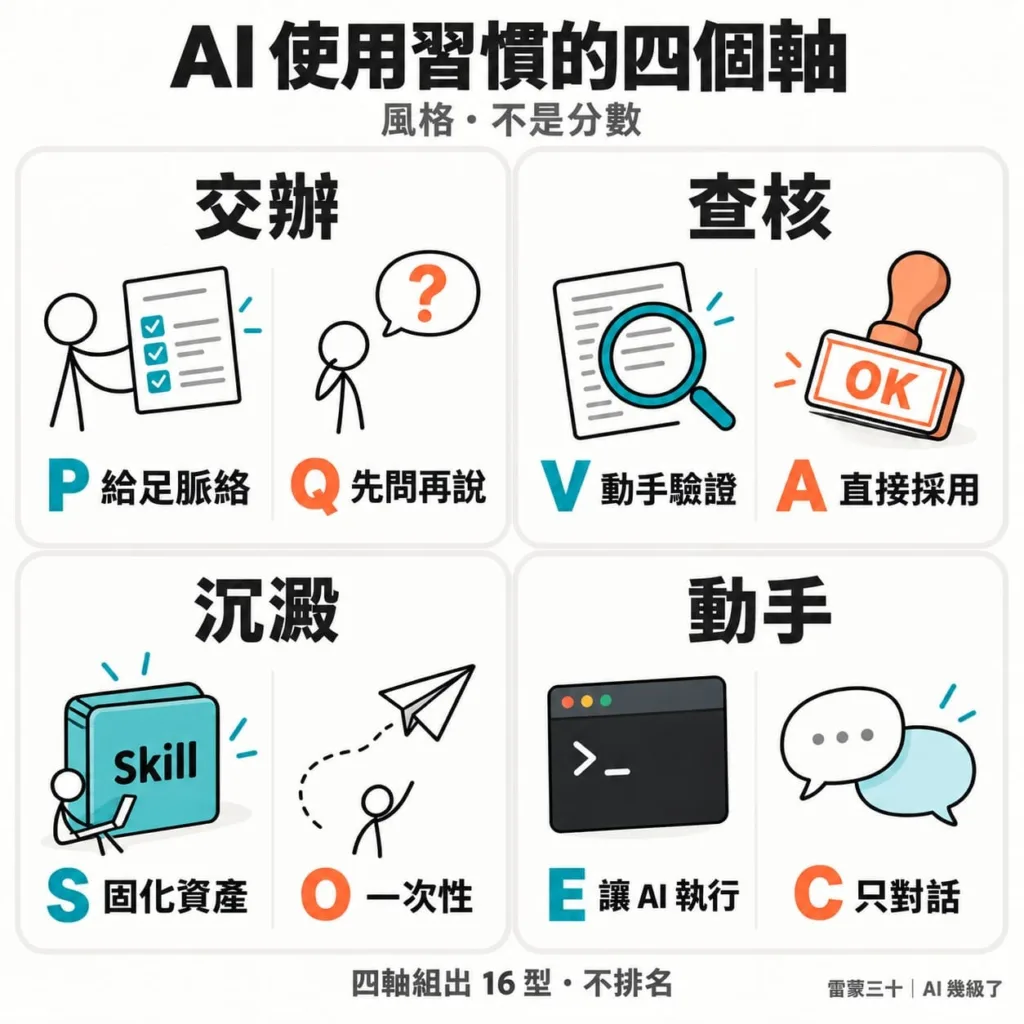
等級看的是「做到哪」,人物誌看的是「怎麼用」。報告從四個軸觀察你的使用習慣:
| 軸 | 一端 | 另一端 |
|---|---|---|
| 交辦 | P:給足脈絡 | Q:先問再說 |
| 查核 | V:動手驗證 | A:直接採用 |
| 沉澱 | S:固化資產 | O:一次性 |
| 動手 | E:讓 AI 執行 | C:只對話 |
四個軸組出 16 型。同樣是 LV3,有人是先想清楚、做完留下能跑的東西的「PVSE 系統建築師」;也有人是想到就試、試完就丟的「QVOE 直覺實驗家」。
人物誌描述的是風格,沒有哪一型比較高級。一個「QAOC 閒聊夥伴」可能是 LV3,一個「PVSE 系統建築師」也可能只到 LV2。
怎麼測出你的 AI 使用等級?
不管你是正在招人的面試官、想評估團隊的主管,還是想知道自己 AI 用得怎樣的個人工作者,我都建議第一份報告先跑你自己的。
你會比較清楚報告會寫什麼、哪些地方準、哪些地方要打個問號。
拿去評估別人之前,先讓它評估你一次,也比較公平。
方法一:你已經在用 Claude Code、Codex 或 Cursor。
把 Skill 裝進你的 AI Agent,然後對它說:「幫我跑這兩週的 AI 使用檢核。」它會先經過同意閘門,再掃描本機紀錄、產出報告。
以 Claude Code 為例,安裝只要兩行:
git clone https://github.com/Raymondhou0917/ai-level-check.git ~/ai-level-check
ln -s ~/ai-level-check ~/.claude/skills/ai-level-check
Codex、Cursor 的安裝方式,請看 GitHub README 裡的 install 文件。只想先看數字、不要完整報告,也可以直接跑收集腳本:
python3 ~/ai-level-check/scripts/collect.py --days 14方法二:你只用 ChatGPT、Gemini 網頁版。
打開專案裡的貼上模式 Prompt,複製貼進網頁對話。這條路看得到你的問答習慣,看不到排程和本機腳本,等級通常最多穩到 LV3。這跟能力強弱無關,純粹是網頁版看不到你硬碟上的系統。
還沒裝、想先看報告長怎樣?我做了一個公開 Demo 報告,裡面有 LV1、LV3、LV4 三份虛構的完整報告,可以對照著看。
隱私:純本機執行
讀對話紀錄聽起來很敏感,隱私邊界一開始就寫死在規則裡:
- 純本機執行:掃描腳本只用 Python 標準庫,不連網、不上傳
- 自動脫敏:家目錄路徑、Email、電話、常見金鑰格式在存檔前自動遮掉
- 不做排名:不給總分、不給百分位,也不說你勝過多少人。世界上沒有可查證的 AI 使用能力資料庫,那些數字寫出來只能是編的
- 對話有客戶資料:可以用
--no-content模式跑,報告只留計數與行為描述,不含任何原文
面試時,怎麼判斷應徵者的 AI 能力?
如果直接問「你 AI 應用能力怎麼樣?」,對方只要面試前做過功課,就能列出一串工具名稱,再講一個用 AI 完成的案例。
這時面試官聽到的是表達能力,不一定是 AI 能力,因為會講 Prompt Engineering 的名詞,跟交辦任務時會給完成標準,是兩種完全不同的能力。
現在我會改成三步:
- 請面試者在他自己的電腦安裝這個 Skill
- 讓面試者跑一份最近兩週的報告
- 讓面試者用螢幕分享給你看,或當場用他的電腦打開報告
報告最好的用法是當作面試的話題起點。挑報告裡的具體案例請他說明,你會比看等級本身學到更多:
| 想知道 | 看報告哪裡 | 可以追問 |
|---|---|---|
| 交辦能力 | 交辦時有沒有給背景、範圍、完成標準 | 「這個任務你當時怎麼交代的?」 |
| 糾錯能力 | AI 答錯時,他怎麼修正 | 「你怎麼發現這裡錯了?」 |
| 沉澱習慣 | 有沒有留下模板、Skill 或自動流程 | 「這個流程後來還有在用嗎?」 |
| 工作風格 | 16 型人物誌 | 「你覺得這個分型準嗎?哪裡不像你?」 |
真的有在使用 AI 的人,講得出細節;臨時準備的人,通常講到第二層就卡住。(延伸閱讀:怎麼判斷遠距工作的人才?如何面試、準備資料?)
團隊 AI 能力評估與導入盤點
團隊導入 AI 一段時間後,主管真正想知道的通常是:
團隊整體的 AI 用到哪裡了?卡在哪裡?是工具沒裝、不會交辦,還是做出來的東西沒人維護?這兩件事,口頭問問不出來,問卷也填不出來。
導入方式決定成敗。 這套工具讀的是一個人每天工作時打的字,技術上做得到監控。擋住它被拿去監控的,只有制度。所以團隊導入一定要守三個原則:
| 原則 | 具體做法 |
|---|---|
| 自願制 | 不強制每個人都要跑 |
| 本人自己跑 | 沒有遠端集中掃描,主管拿不到任何人的原始對話 |
| 本人決定推不推 | 報告產出後,由本人看過、自己決定要不要分享給團隊 |
專案裡有一支 publish.sh,可以把報告推進團隊的 private repo,但它不會自動推送,推之前還會先掃一次金鑰。
完整的團隊部署說明,請看 GitHub 上的 install/team-deploy.md。
盤點時,整個團隊的共同模式比個人等級更值得看。
如果大家分享出來的人物誌都偏 A(直接採用、不查核),代表整個團隊有個共同盲點:AI 給什麼就用什麼,沒有人在驗證!
| 觀察到的模式 | 可能的意思 | 可以怎麼處理 |
|---|---|---|
| 大家都偏 O(一次性) | 好用的做法沒有沉澱,每個人都在重新發明輪子 | 挑一個高頻任務,一起做成共用模板或 Skill |
| 大家都偏 C(只對話) | AI 只在聊天,沒有實際動手改檔案、跑流程 | 安排一次 AI Agent 實作工作坊 |
| 自動化齒輪幾乎都沒動到 | 工作都需要人在場才會發生 | 先從時間排程開始,挑一個每週重複的報告 |
| 等級落差很大 | 少數人很會用,經驗沒有擴散 | 請高等級的同事分享他的 Skill 和工作流 |
最後提醒一次:報告不能用來排名,也不能單獨作為考績、升遷、解僱或調職的依據。
個人工作者,每月自我審查
如果你是自由工作者、一人公司1,身邊沒有主管或同事能給你回饋,這份報告就是你的鏡子。
拿到報告後,我建議你直接跳到「沒做好什麼」和「下一步」。真正能讓你進步的,是報告指出的具體缺口。
我自己第一次測是 LV4+,看了報告後,發現我的 Gmail 助理在處理演講邀約時信,若遇到邀約資訊不完整時,它不會停下來問,會自己腦補一個報價。
如果哪天我太忙、沒仔細看就送出,對方收到的就是一個錯誤的報價!
現在透過報告,我馬上就能直接修改優化!
常見問題 FAQ
請應徵者在自己的電腦跑一份最近兩週的報告,螢幕分享給你看,再挑報告裡的具體案例請他說明:當時怎麼交代任務、怎麼發現 AI 答錯、後來有沒有把做法留下來。真的做過的人,講得出細節;臨時準備的人,通常講到一半就會卡住。
不一定。
報告的原則是「未觀察到不等於不會」。如果你的高階用法發生在沒有紀錄的地方,例如網頁版、白板、口頭交辦,報告應該寫「目前可確認至 LV2;較高等級尚未評估」。如果報告直接判你只有 LV2,那是誤判,歡迎到 GitHub 回報 issue。
建議每月一次。預設掃描最近 14 天的紀錄,每次只挑報告建議的「下一步」補一件事,下個月再測一次看有沒有補起來。測太頻繁意義不大,你的用法需要時間累積出新的紀錄。
🔥 五星好評|24 小時開始活用 AI Agent(Claude Code、Codex 都適用)
為什麼大多數人用不好?因為你的 AI Agent 一開始太空白、你也不知道從何訓練。
這堂迷你課,設計為可以直接餵給 Claude Code,它會快速學會這些「武功秘笈」!
- 【基礎設定引導檔】讓你直接丟給你 AI Agent,讓它快速升級的
- 【實戰應用 Skill 組合】,幫你省下 10+ 小時的迷惘摸索期,讓你的 AI Agent 快速好用
👉 已超過 5,800 人購買、130 則評價:前往觀看課程
(記得收藏持續更新的 Claude Code 學習資源)
📍 AI Agent(Claude Code、Codex)系列教學文章
- Claude Code vs Codex 完整教學|新手怎麼選?非工程師也能上手的桌面版比較
- 為什麼 AI 越聊越笨?Context Window、Compact 與額度管理入門教學
- AI Agent 搬家教學:Claude Code 轉 Codex?AGENTS.md、CLAUDE.md 與記憶系統設計?
- 讓 AI 助理看懂網頁:Firecrawl、Playwright、WebFetch 三大抓取工具完整比較
- 白話文教學:AI 怎麼幫你動手做事?API、CLI、MCP、瀏覽器控制的選擇邏輯
- Vibe Coding 學習筆記:為什麼要重複造輪子?
- Claude Code 是什麼?從 Claude Cowork 到 Code,非工程師也能上手的完整入門教學
- 21 天,我用 Claude Code 打造了一整套 AI 分身助理記錄
- 做好了,然後呢?Cloudflare、Zeabur 與 Railway 部署路線完整指南
- Claude Cowork 更好用了?它跟 NotebookLM 差在哪?什麼時候才需要升級到 Code?
- Claude Code 的 CLAUDE.md 和 SKILL 教學,打造可重複使用的AI 自動化工作流
- Claude Code 桌面版 vs 終端機:你該用哪一個?
- 為什麼一般人不需要刻意打造 AI Agent Team?
- AI 學習路徑全攻略:Prompts、知識庫、AI Agent 的 3 個階段
- 有了 AI Agent 之後,Notion 跟 n8n 就可以丟了嗎?三者關係與我的實戰用法
- Zeabur 專用伺服器怎麼選?白話文選購指南,讓 AI 幫你搬家!
- Zeabur 應用案例:網站部署、龍蝦 OpenClaw、VPS(50% 折扣)
本文註腳補充
- 想知道遠距工作還有哪些自我管理的方法?可以看這堂《24 小時開始成為遠距工作者》。 ↩︎